
Los agentes de inteligencia artificial están transformando nuestra forma de desarrollar software. Herramientas como Claude Code, OpenCode o Codex permiten delegar tareas cada vez más complejas, pero todavía presentan una limitación importante: la dificultad para conservar lo aprendido durante las sesiones de trabajo.
Es habitual corregir una decisión técnica, resolver un error o explicar nuestras preferencias de programación y descubrir que, al comenzar una nueva sesión, tenemos que repetir parte de esa información. Para solucionar este problema están apareciendo diferentes mecanismos de memoria persistente, algunos basados en archivos Markdown y otros integrados directamente en los propios agentes.
Los archivos Markdown como memoria persistente
El uso de archivos Markdown para proporcionar contexto a los agentes no es nuevo. Archivos como AGENTS.md o CLAUDE.md permiten definir instrucciones, convenciones de desarrollo y características del proyecto que el agente debe tener en cuenta.

Sin embargo, existe una diferencia entre documentar cómo debe trabajar un agente y conservar lo que ha aprendido mientras trabajaba. Por ejemplo, podemos indicar en AGENTS.md qué herramientas utilizamos, pero si durante una sesión descubrimos una incompatibilidad y encontramos su solución, sería interesante que el agente pudiera recordarla en el futuro.
Aquí entran en juego los archivos de memoria persistente, que permiten almacenar decisiones técnicas, problemas resueltos, preferencias y otros conocimientos reutilizables. Su principal ventaja es que utilizan un formato sencillo, legible y versionable mediante Git, aunque necesitan mecanismos que permitan actualizar su contenido y recuperarlo cuando sea necesario.
MEMORY.md: conservar conocimientos entre sesiones
Una de las aproximaciones más sencillas consiste en utilizar un archivo MEMORY.md donde registrar información relevante que debería sobrevivir a las conversaciones.

Este archivo puede recoger decisiones de arquitectura, características del entorno, soluciones a errores o cualquier otro conocimiento que resulte útil para futuras tareas. El objetivo no es guardar todas las conversaciones, sino seleccionar la información que merece la pena conservar.
De esta manera, el agente puede disponer de un contexto más completo sin necesidad de repetir investigaciones o explicaciones anteriores.
TASTE.md: aprender las preferencias del desarrollador
Una propuesta interesante es TASTE.md, de PitayaK, que introduce un concepto diferente: recordar no solo lo que sabemos, sino también cómo nos gusta trabajar.
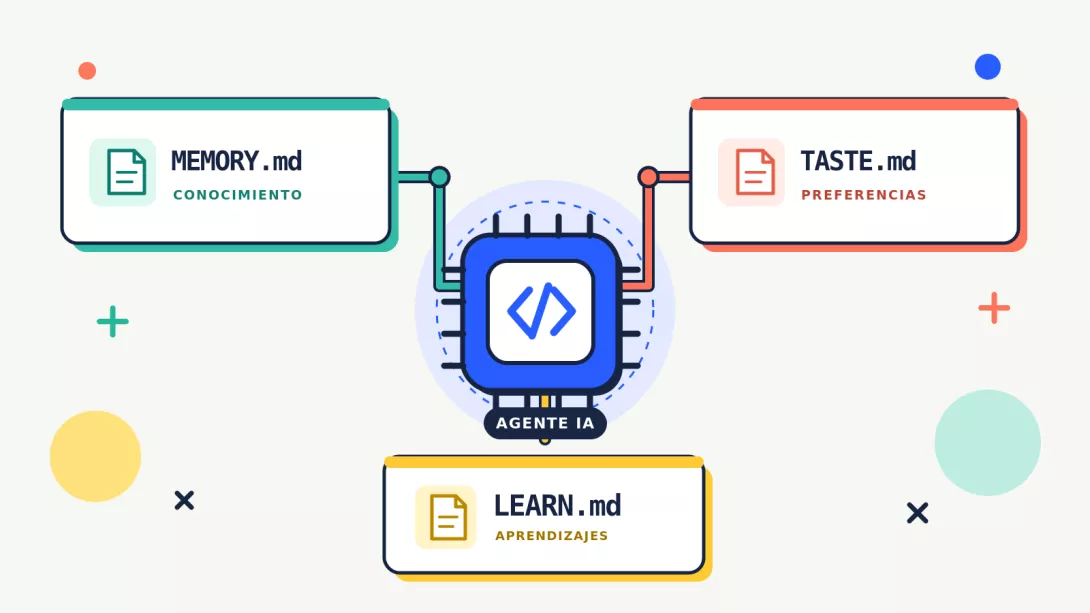
El proyecto propone separar tres archivos: SOUL.md, que define la identidad del agente; MEMORY.md , que conserva información relevante; y TASTE.md que registra las preferencias y criterios de calidad del usuario.
Aplicado al desarrollo de software, esto permite recoger preferencias sobre arquitectura, organización del código o estilos de programación. Por ejemplo, que prioricemos soluciones sencillas frente a abstracciones innecesarias o que prefiramos determinados patrones de implementación.
Lo interesante es que estas preferencias pueden identificarse a partir de nuestras correcciones y decisiones, sin necesidad de definirlas todas previamente mediante instrucciones explícitas.
Taste: convertir las correcciones en aprendizajes
El proyecto taste, de toshon-jennings, lleva este concepto un paso más allá con una implementación orientada a Claude Code y OpenCode.
Su funcionamiento consiste en capturar señales de nuestras interacciones, como modificaciones del código o acciones rechazadas, para identificar posibles preferencias. Posteriormente, el agente puede analizar esa información y proponer reglas que se almacenan en archivos Markdown.
El sistema utiliza niveles de confianza para distinguir entre decisiones puntuales y preferencias recurrentes, y permite revisar los aprendizajes antes de consolidarlos. Una vez incorporados, pueden utilizarse como contexto en futuras sesiones.
Command Code y el concepto de Coding Taste
Esta aproximación está relacionada con el concepto de Coding Taste, desarrollado por Command Code, que propone aprender de las aceptaciones, rechazos y modificaciones que realiza el desarrollador.
Command Code organiza estas preferencias en paquetes de conocimiento que pueden aplicarse globalmente o a proyectos específicos. También permite compartirlos, de modo que los criterios de desarrollo puedan reutilizarse entre diferentes agentes o miembros de un equipo.
Ambas iniciativas muestran cómo podemos pasar de escribir instrucciones manualmente a construir una memoria que evoluciona a partir de nuestra interacción con el agente.
Mi experiencia con LEARN.md en OpenCode
En mi caso, utilizo OpenCode y he optado por una aproximación propia basada en archivos LEARN.md, con los que busco unificar en un único lugar los conceptos que otras propuestas separan en archivos como SOUL.md, MEMORY.md o TASTE.md.
La idea es conservar tanto conocimientos técnicos como preferencias y patrones de comportamiento que el agente va identificando durante nuestras interacciones. Para organizar esta información utilizo dos niveles de memoria.
Por una parte, mantengo un LEARN.md global, donde se registran aprendizajes aplicables a cualquier desarrollo, como preferencias de programación, criterios de calidad o aspectos relacionados con mi forma de trabajar. Por otra, utilizo un LEARN.md específico para cada proyecto, destinado a conservar decisiones técnicas, problemas resueltos, convenciones y particularidades de ese repositorio.

Lo interesante de este enfoque es que no mantengo estos archivos únicamente de forma manual. Tengo un agente de desarrollo personalizado en OpenCode encargado de identificar y gestionar los aprendizajes que surgen durante el trabajo. Cuando detecta un patrón recurrente, una preferencia o una corrección relevante, tanto a nivel técnico como conductual, analiza si merece la pena conservar esa información y determina si debe convertirse en una regla global o específica del proyecto.
De esta manera, una preferencia sobre cómo estructurar el código o cómo quiero que el agente interactúe conmigo puede incorporarse a la memoria global, mientras que una solución relacionada con una dependencia o una decisión arquitectónica concreta permanece en la memoria del proyecto correspondiente.
Aunque LEARN.md no es una funcionalidad nativa de OpenCode, sus mecanismos de instrucciones y agentes personalizados permiten implementar este tipo de comportamiento sin necesidad de desarrollar una extensión adicional. El resultado es un sistema de memoria que evoluciona con el uso, en el que las correcciones, decisiones y experiencias pueden transformarse en reglas persistentes que el agente reutiliza en futuras sesiones.
Hermes Agent: la memoria como parte de la arquitectura del agente
Los ejemplos anteriores se basan en archivos Markdown que gestionamos manualmente o mediante herramientas adicionales. Sin embargo, también otro enfoque diferente: integrar la memoria directamente en el harness, es decir, la infraestructura que gestiona las herramientas, las sesiones, el contexto y el funcionamiento del agente.
Un ejemplo es Hermes Agent, desarrollado por Nous Research, que incorpora mecanismos de memoria persistente y aprendizaje como parte de su arquitectura.
Hermes utiliza archivos MEMORY.md y USER.md para conservar conocimientos sobre el entorno y las preferencias del usuario. Estos archivos se incorporan al contexto de nuevas sesiones y pueden actualizarse mediante herramientas específicas del agente.
Además, dispone de mecanismos para recuperar información de conversaciones anteriores y puede generar skills reutilizables mediante archivos SKILL.md. Esto permite que determinadas experiencias no se conserven únicamente como recuerdos, sino también como procedimientos que el agente puede volver a ejecutar cuando los necesite.
Lo interesante de este enfoque es que la gestión de la memoria deja de depender exclusivamente de archivos mantenidos por el desarrollador y comienza a formar parte del funcionamiento del propio agente.
En cualquier caso, conviene distinguir este aprendizaje del entrenamiento de un modelo de lenguaje. Estos mecanismos normalmente no modifican los parámetros del modelo, sino que proporcionan una memoria externa que permite recuperar conocimientos y utilizarlos en futuras interacciones.
La evolución desde soluciones sencillas como LEARN.md hasta sistemas integrados como Hermes muestra la importancia que está adquiriendo la memoria en el desarrollo asistido por IA. No se trata únicamente de conseguir agentes capaces de generar código, sino de que puedan aprovechar las experiencias anteriores para evitar errores, reutilizar soluciones y adaptarse progresivamente a nuestra forma de trabajar.